Domain nuve.de kaufen?
Wir ziehen mit dem Projekt
nuve.de um.
Sind Sie am Kauf der Domain
nuve.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain nuve.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **

Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Kermi Aufpreis Sonderkonstruktion - DienstleistungDie Fakten - Maßanpassungen vor Ort – z. B. Zuschneiden von Profilen oder Glaselementen wegen schiefer Wände oder Sondermaßen - Sonderbefestigungen – Montage bei schwierigen Wandmaterialien (Naturstein, Porenbeton, Trockenbau mit Verstärkung etc.) - Individuelle Abdichtungslösungen – zusätzliche Silikonfugen, Spezialdichtprofile, Anpassungen bei unebenen Flächen - Anpassung an bauliche Besonderheiten – Dachschrägen, Vorsprünge, Nischen, Rohre, Fensterbänke - Zusatzkonstruktionen – Haltewinkel, Verstärkungsleisten oder Sonderhalterungen, die nicht im Standard-Montagesatz enthalten sind - Erhöhter Montageaufwand – deutlich längere Arbeitszeit wegen komplizierter Einbausituation99,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
Wie funktionieren Webcrawler und welche Vorteile bieten sie für die Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Informationen von Websites sammeln. Sie folgen Links von einer Seite zur nächsten, um Inhalte zu indexieren und in Suchmaschinen verfügbar zu machen. Dadurch wird die Auffindbarkeit von Websites verbessert und die Aktualität der Suchergebnisse gewährleistet. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
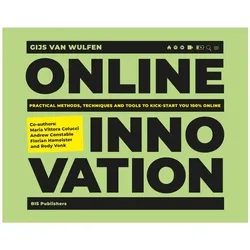
Online innovation, Fachbücher von Gijs Van WulfenOnline Innovation inspiriert mit effektiven Tools, Techniken, Methoden und Regeln für die Online-Zusammenarbeit, damit Sie Ihre Arbeit und Ihr Unternehmen zu 100 % online ausrichten können. Nachdem die Autoren 10 häufige Fallstricke beschrieben haben, stellen sie grossartige Tools und Techniken vor, die in der Praxis funktionieren. Sie diskutieren die Achillesferse der Online-Arbeitsentwicklung und beschreiben 10 Methoden, die Sie für die praktische Online-Arbeit nutzen können. Lightning Decision Jam, Design Sprint und die Innovationsmethode FORTH werden im Buch hervorgehoben. Die Autoren kombinieren diese Methoden zu einer neuen Hybridversion. Am Ende des Buches finden Sie systematische Beschreibungen von 25 Tools und 10 Methoden. Diese geben einen klaren Überblick, der Ihnen helfen wird, die richtigen für Ihre berufliche Online-Reise auszuwählen.33,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kermi Aufpreis Sonderkonstruktion - DienstleistungDie Fakten - Maßanpassungen vor Ort – z. B. Zuschneiden von Profilen oder Glaselementen wegen schiefer Wände oder Sondermaßen - Sonderbefestigungen – Montage bei schwierigen Wandmaterialien (Naturstein, Porenbeton, Trockenbau mit Verstärkung etc.) - Individuelle Abdichtungslösungen – zusätzliche Silikonfugen, Spezialdichtprofile, Anpassungen bei unebenen Flächen - Anpassung an bauliche Besonderheiten – Dachschrägen, Vorsprünge, Nischen, Rohre, Fensterbänke - Zusatzkonstruktionen – Haltewinkel, Verstärkungsleisten oder Sonderhalterungen, die nicht im Standard-Montagesatz enthalten sind - Erhöhter Montageaufwand – deutlich längere Arbeitszeit wegen komplizierter Einbausituation99,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
Kermi Montageaufpreis für Sonderbohrungen - DienstleistungSpezialbohrungen Beim Einbau unserer Duschkabinen auf speziellen Fliesen wie Granit, Feinsteinzeug oder sonstigen harten Fliesenmaterialen ist ein erhöhter Zeitaufwand und Spezialwerkzeug notwendig.149,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
-
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
-
Wie funktionieren Webcrawler und welche Vorteile bieten sie für die Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Informationen von Websites sammeln. Sie folgen Links von einer Seite zur nächsten, um Inhalte zu indexieren und in Suchmaschinen verfügbar zu machen. Dadurch wird die Auffindbarkeit von Websites verbessert und die Aktualität der Suchergebnisse gewährleistet. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.